PYSPARK – PROCESSAMENTO DE DADOS
- Best of, Big Data e Analytics, PRO
- 0 (Registered)

A formação PySpark – Processamento de Dados é ideal para profissionais que trabalham com grandes volumes de dados e pretendem dominar o processamento distribuído utilizando Python com Apache Spark. Durante 3 dias, os participantes aprendem o funcionamento do ecossistema Hadoop, compreendem a arquitetura do Spark, manipulam dados com DataFrames e Spark SQL, aplicam algoritmos de Machine Learning com MLlib e trabalham com dados em tempo real através de Spark Streaming. Com uma forte componente prática, esta formação capacita para desenvolver pipelines de dados escaláveis e de alto desempenho em ambientes locais, distribuídos ou cloud.
- Descrever o princípio de funcionamento do Spark.
- Utilizar a API PySpark para interagir com o Spark em Python.
- Implementar métodos de Machine Learning com a biblioteca MLlib do Spark.
- Tratar fluxos de dados com o Spark Streaming.
- Manipular dados com o Spark SQL.
INTRODUÇÃO AO HADOOP
• A era do Big Data
• Arquitetura e componentes da plataforma Hadoop
• HDFS
• NameNode / DataNode / ResourceManager
• MapReduce e YARN
INTRODUÇÃO AO SPARK
• O que é o Spark?
• Spark vs MapReduce
• Funcionamento
• RDD
• DataFrames
• Data Sets
• Como interagir com o Spark?
• PySpark: programar com Spark em Python
INSTALAÇÃO DO SPARK
• Numa infraestrutura distribuída
• Em local
• Em Cloud (apresentação com Amazon AWS e Microsoft Azure)
SPARK PARA MANIPULAÇÃO DE DADOS – PYSPARK
• Utilização de SparkSQL e de DataFrames para manipular dados
• Carregar dados a partir do Hadoop, de ficheiros CSV, texto, JSON
• Transformar dados (criação de DataFrames, adição de colunas, filtros)
Exemplo de trabalhos práticos:
• Carregamento e alteração de dados com Spark e PySpark
UTILIZAÇÃO DE SPARK.ML PARA MACHINE LEARNING
• Aprendizagem supervisionada
• Florestas aleatórias com Spark
• Implementação de uma ferramenta de recomendação
• Tratamento de dados textuais
• Automatizar as análises com pipelines
SPARK STREAMING
• Introdução ao Spark Streaming
• A noção de “DStream”
• Principais fontes de dados
• Utilização da API
• Manipulação dos dados
SPARK SQL
• Introdução ao Spark SQL
• Criação de DataFrames
• Manipulação de DataFrames (operações básicas, agregações e groupBy, missing data)
• Carregamento e armazenamento de dados (com Hive, JSON)
GRAPHX E GRAPHFRAMES
• Apresentação do GraphX
• Princípio de criação de grafos
• API GraphX
• Apresentação do GraphFrames
• GraphX vs GraphFrames
Facilitador que combina know-how com experiência empresarial e competências pedagógicas, para dar resposta a necessidades operacionais e potenciar a aprendizagem.
Objetivos da formação
- Descrever o princípio de funcionamento do Spark.
- Utilizar a API PySpark para interagir com o Spark em Python.
- Implementar métodos de Machine Learning com a biblioteca MLlib do Spark.
- Tratar fluxos de dados com o Spark Streaming.
- Manipular dados com o Spark SQL.
Duração da formação
Programa da formação
INTRODUÇÃO AO HADOOP
• A era do Big Data
• Arquitetura e componentes da plataforma Hadoop
• HDFS
• NameNode / DataNode / ResourceManager
• MapReduce e YARN
INTRODUÇÃO AO SPARK
• O que é o Spark?
• Spark vs MapReduce
• Funcionamento
• RDD
• DataFrames
• Data Sets
• Como interagir com o Spark?
• PySpark: programar com Spark em Python
INSTALAÇÃO DO SPARK
• Numa infraestrutura distribuída
• Em local
• Em Cloud (apresentação com Amazon AWS e Microsoft Azure)
SPARK PARA MANIPULAÇÃO DE DADOS – PYSPARK
• Utilização de SparkSQL e de DataFrames para manipular dados
• Carregar dados a partir do Hadoop, de ficheiros CSV, texto, JSON
• Transformar dados (criação de DataFrames, adição de colunas, filtros)
Exemplo de trabalhos práticos:
• Carregamento e alteração de dados com Spark e PySpark
UTILIZAÇÃO DE SPARK.ML PARA MACHINE LEARNING
• Aprendizagem supervisionada
• Florestas aleatórias com Spark
• Implementação de uma ferramenta de recomendação
• Tratamento de dados textuais
• Automatizar as análises com pipelines
SPARK STREAMING
• Introdução ao Spark Streaming
• A noção de “DStream”
• Principais fontes de dados
• Utilização da API
• Manipulação dos dados
SPARK SQL
• Introdução ao Spark SQL
• Criação de DataFrames
• Manipulação de DataFrames (operações básicas, agregações e groupBy, missing data)
• Carregamento e armazenamento de dados (com Hive, JSON)
GRAPHX E GRAPHFRAMES
• Apresentação do GraphX
• Princípio de criação de grafos
• API GraphX
• Apresentação do GraphFrames
• GraphX vs GraphFrames
Formador
Facilitador que combina know-how com experiência empresarial e competências pedagógicas, para dar resposta a necessidades operacionais e potenciar a aprendizagem.
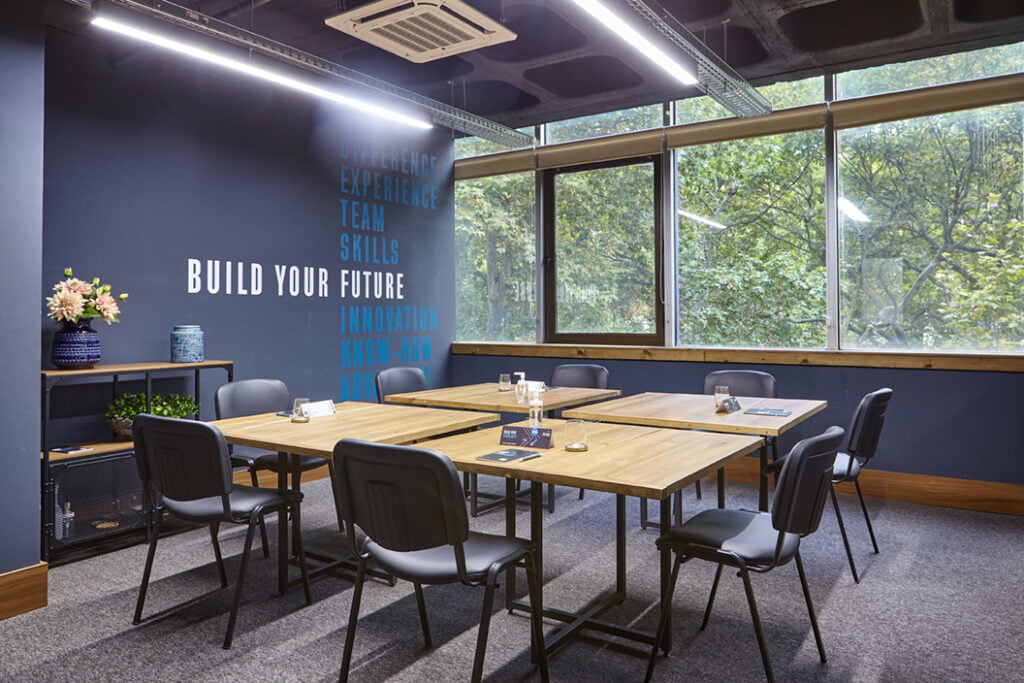
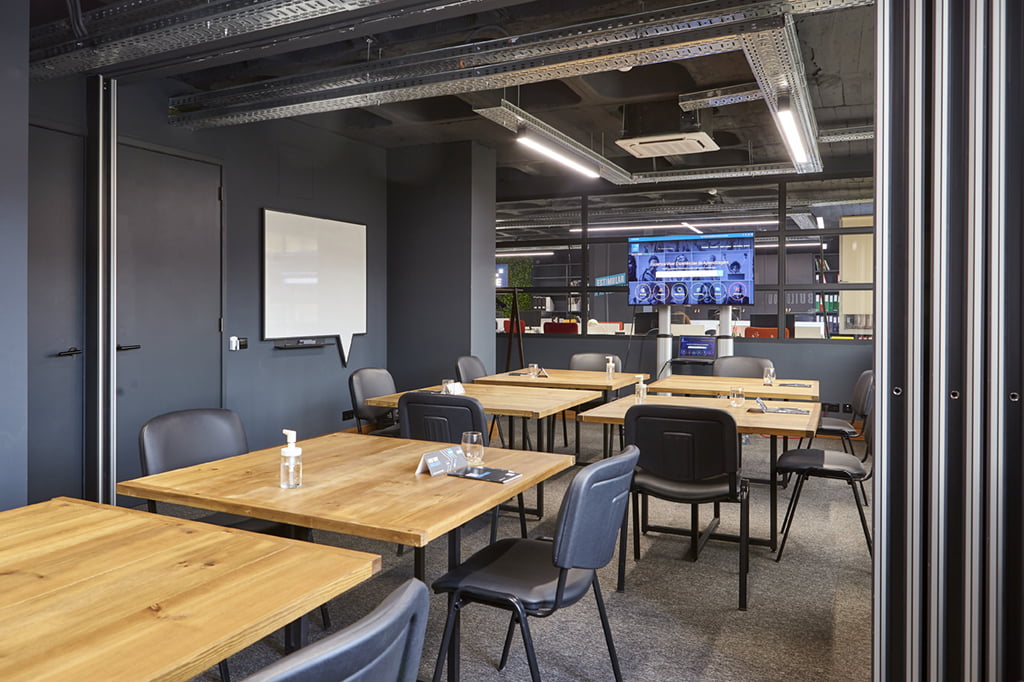
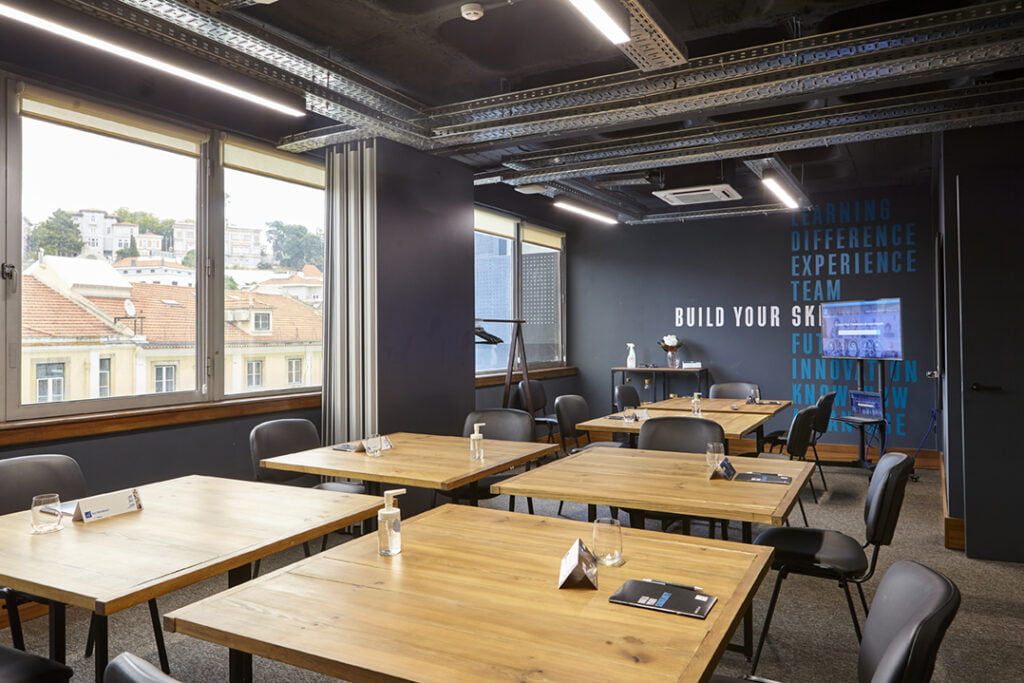
Clique na imagem para expandir
Os nossos espaços de formação oferecem todas as condições para continuar o seu desenvolvimento pessoal e profissional em absoluta segurança
Não se esqueça de subscrever o blog RhBizz e de nos seguir no LindekIn, Facebook, Instagram e Youtube.